Stand: 17. November 2026. Dieser Beitrag dokumentiert 30 Benchmark-Iterationen in einem abgeschlossenen Verbesserungszyklus für SupraAgent. Das wichtigste Ergebnis ist kein neuer Gesamtscore. Der Benchmark macht jetzt genauer sichtbar, wo Qualität verloren geht: an der Position eines Belegs in langen Dokumenten, beim Retrieval, beim Zitieren, beim Formulieren der ersten Aussage, bei der Entscheidung „nicht gefunden“ und beim Umgang mit manipulierten Quellen.
Der Zyklus umfasst 30 dokumentierte Arbeits- und Entscheidungsiterationen. Das sind nicht 30 statistisch unabhängige Wiederholungen desselben Experiments. Jede Iteration hatte eine eigene Fragestellung, ein Ergebnis und eine Entscheidung. Ein Kandidat wurde verworfen, weil er mehrere Gates nicht bestand; eine Holdout-Iteration blieb bewusst ergebnisoffen, weil kein frischer versiegelter Datensatz vorlag. Die abschließende fokussierte Integrationssuite bestand 182 Tests, 0 schlugen fehl; die Laufzeit betrug 276,04 Sekunden.
Diese Zahlen stammen aus lokalen, deterministischen Fixtures mit dem Produktcode, aber ohne Provider-Aufruf und ohne von einem Sprachmodell neu formulierte Antworten. Sie sind weder eine Produktions-SLO noch eine unabhängige Bewertung der Antwortqualität. Sie belegen insbesondere nicht, dass SupraAgent „der beste Assistent der Welt“ ist. Dafür fehlen ein fairer Vergleich mit anderen Systemen, repräsentative Kundendaten, unabhängige menschliche Bewertungen und Messungen unter Produktionslast.
Was wurde gemessen?
Im Mittelpunkt stehen Fragen zur Produktdokumentation: Welche Funktion gehört zu einer Frage? Wird der richtige Beleg gefunden und zitiert? Steht er in der ersten Aussage? Erkennt das System, wenn die Dokumentation keine passende Funktion enthält? Zusätzlich prüft der Zyklus lange Eingaben, Teillesung, wiederholte Scans, manipulierte Dokumente sowie lokale Laufzeit- und Prozessspeicherdiagnosen.
Das Messprotokoll folgt fünf Regeln:
Zähler und Nenner bleiben sichtbar; Fehler werden nicht aus der Auswertung entfernt.
Lange Kontexte werden nach Länge und Belegposition getrennt statt nur als Mittelwert berichtet.
Retrieval, Zitat, erste Aussage, Enthaltung, Sicherheit und Laufzeit sind getrennte Messgrößen.
Entwicklungssätze und bereits geöffnete Holdouts dürfen keine neue blinde Promotionsaussage begründen.
Ein Kandidat wird nur übernommen, wenn seine vorab festgelegten Gates bestehen; ein negatives Ergebnis bleibt im Protokoll.
Abgrenzung zur vorherigen Fassung
Der vorherige Beitrag berichtete zusätzlich über eigene Fixtures für Kontaktsuche und digitale Zwillinge, eine ältere Langkontext-Suite mit 612 Dokumenten sowie eine Kampagne mit 11.232 Versuchen zu eingeschleusten Dokumenten. Diese Ergebnisse gehören weiterhin zur früheren Round-Five-Belegsammlung. Die abschließende 182-Test-Integrationssuite des hier beschriebenen 30-Iterationen-Zyklus deckt dagegen die Modulfunktions-, Langkontext-, Poisoning-, Provenienz- und Prozesslastpfade ab. Dieser Ersatztext übernimmt die älteren Kontakt-, Zwilling- und 612-Dokument-Zahlen deshalb nicht so, als wären sie auf dem final eingefrorenen Baum erneut gemessen worden.
Ausgangspunkt: solide Trefferquote, schwache erste Aussage und begrenzte Enthaltung
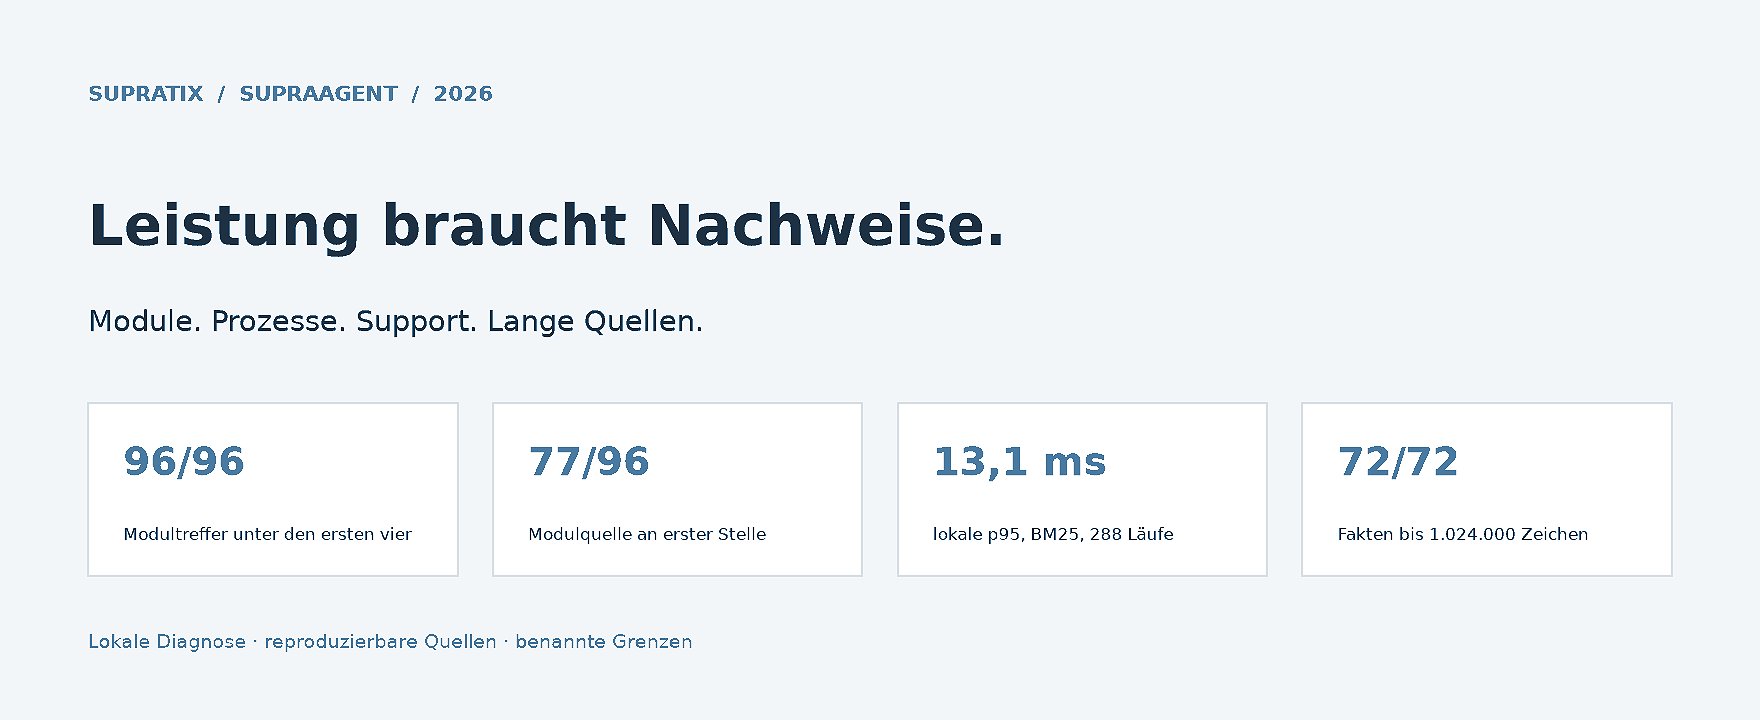
Auf dem reproduzierten Entwicklungssatz fand das fusionierte Retrieval die relevante Funktion bei 127 von 144 Fragen unter den ersten vier Treffern. BM25 allein erreichte 126 von 144. Bei den 96 Fragen mit einer vorhandenen Zielfunktion stand diese jedoch nur bei 54 beziehungsweise 63 Fragen in der ersten Aussage. Bei 48 Fragen nach nicht vorhandenen Funktionen antwortete das fusionierte Verfahren in 23 Fällen mit „nicht gefunden“, BM25 in 20.
Der neue Retrieval–Zitat–Lead-Trichter erklärt den größten Teil dieses Verlusts. Beim fusionierten Verfahren wurde die Goldfunktion bei 58 von 96 Fragen überhaupt für die Antwort zugelassen, danach in 55 von 58 Fällen zitiert und in 54 von 55 Fällen in die erste Aussage gesetzt. Bei BM25 lautete der Trichter 69 von 96, 66 von 69 und 63 von 66. Sobald der richtige Beleg zugelassen ist, funktioniert die Übernahme in Zitat und erste Aussage häufig. Der dominante Engpass liegt vorher: beim Finden und Zulassen des richtigen Belegs.
„Nicht gefunden“ wird jetzt als Klassifikationsproblem ausgewertet
Eine hohe Trefferzahl bei nicht beantwortbaren Fragen kann irreführend sein, wenn das System gleichzeitig viele beantwortbare Fragen ablehnt. Deshalb enthält der Bericht jetzt die vollständige Konfusionsmatrix. Beim fusionierten Retrieval gab es 5 falsche Enthaltungen unter 144 beantwortbaren Fragen. Die Präzision der „nicht gefunden“-Antworten betrug 23/28, die Spezifität 139/144 und die Balanced Accuracy 72,22 %. Bei BM25 waren es 9/144 falsche Enthaltungen, eine Präzision von 20/29, eine Spezifität von 135/144 und eine Balanced Accuracy von 67,71 %.
Diese Werte stammen aus dem Entwicklungssatz. Sie sollten nicht als Schätzung für beliebige reale Nutzerfragen gelesen werden. Ihr Wert liegt darin, dass eine scheinbare Verbesserung bei „nicht gefunden“ nicht länger durch zusätzliche Ablehnungen beantwortbarer Fragen verborgen werden kann.
Langer Kontext: Die Position des Belegs zählt
Ein einziger Mittelwert kann verschleiern, ob ein System Belege am Anfang eines Dokuments findet, aber in der Mitte verliert. Der Bericht trennt deshalb Anfang, Mitte und Ende, nennt die schlechteste Position und die Differenz zur besten. Er bewahrt für jedes belegte Stratum außerdem Zähler, Nenner und Wilson-95-%-Intervalle.
Die stärkere eingecheckte Langkontext-Auswertung bündelt die vollständigen Läufe mit 256.000, 512.000 und 1.024.000 Zeichen und wertet die Belegposition getrennt aus. Beim fusionierten Retrieval lag Hit@4 für beantwortbare Fragen am Anfang bei 105/144, in der Mitte bei 103/144 und am Ende bei 98/144. Der Abstand zwischen bester und schlechtester Position beträgt damit 4,9 Prozentpunkte. Bei den 96 Fragen je Position mit markiertem Goldbeleg wurde dieser 48/96, 46/96 und 48/96 Mal zitiert; der Positionsabstand beträgt 2,1 Prozentpunkte.
Daneben existiert ein bewusst kleiner diagnostischer Smoke über dieselben drei Längen. Dort betrug der beste-gegen-schlechteste Abstand 50 Prozentpunkte für Hit@4 und 25 Prozentpunkte für Goldzitate. Dieser Smoke war nützlich, um die Positionsmetrik einzuführen, ist aber keine Populationsschätzung und darf die breitere Auswertung mit 4,9 beziehungsweise 2,1 Prozentpunkten nicht ersetzen.
Das entspricht einem bekannten Befund der Forschung: Liu et al., „Lost in the Middle“ (TACL 2024) zeigen, dass die Leistung von Modellen stark von der Position relevanter Information abhängen kann. LongBench (ACL 2024) motiviert zudem mehrsprachige und aufgabenbezogene Langkontext-Auswertung. Diese Arbeiten bestimmen unser Messdesign; sie validieren nicht die SupraAgent-Ergebnisse.
Teillesung wird sichtbar
Bei langen Eingaben liest SupraAgent nicht zwangsläufig jedes Zeichen. Das ist als Leistungsstrategie vertretbar, darf aber gegenüber Nutzerinnen und Nutzern sowie in der Auswertung nicht unsichtbar bleiben. Im 256k-A/A-Lauf waren alle 114 von 114 Kandidatenfälle unvollständig gelesen. Alle 114 zeigten den Begrenzungshinweis; es gab 0 fehlende Hinweise unter diesen 114 unvollständigen Fällen. Der Lauf enthielt jedoch 0 vollständig gelesene Fälle. Eine Falsch-positiv-Rate des Hinweises ist deshalb nicht schätzbar.
Der Hinweis beweist nicht, dass eine Antwort inhaltlich richtig ist. Er macht lediglich eine wichtige Grenze der Verarbeitung sichtbar. Der Bericht enthält außerdem eine obere Grenze für die gelesene Abdeckung, damit „Antwort vorhanden“ nicht mit „gesamtes Dokument geprüft“ verwechselt wird.
Wiederholte Scans werden gemessen
Der sechs Familien umfassende 256k-A/A-Smoke erreichte 75 % Wiederverwendung für Prefix- und Tail-Scans und verzeichnete 0 nicht zwischengespeicherte Tail-Pässe. Das ist eine lokale Effizienzdiagnose derselben Anfragen, keine Aussage über Cache-Trefferraten unter wechselnder Produktionslast.
Manipulierte Quellen: ein starker Kandidat mit entscheidender Voraussetzung
Der Zyklus trennt drei Stufen eines Poisoning-Angriffs: Taucht das manipulierte Dokument unter den ersten vier Treffern auf? Wird es zitiert? Gelangt sein Canary-Text oder eine eingeschleuste Anweisung in Antwort beziehungsweise Prompt?
In der Basislinie mit 96 fusionierten Versuchen lag ein manipuliertes Dokument 84-mal unter den ersten vier Treffern und 80-mal auf Rang 1. Es wurde 84-mal zitiert; der Canary-Text wurde 35-mal übernommen und Anweisungstoken wurden 30-mal in den Prompt projiziert. Der saubere Zielbeleg lag nur bei 30 von 96 Versuchen unter den ersten vier Treffern.
Ein optionaler Provenienz-Kandidat ordnet ausdrücklich verifizierte Quellen vor ausdrücklich unverifizierten Quellen. Im gepaarten Vergleich derselben 96 Versuche sank die Retrieval-Kontamination unter den ersten vier Treffern von 84 auf 0 und die Zahl manipulierter Rang-1-Treffer von 80 auf 0. Manipulierte Zitate sanken von 84 auf 0, Canary-Übernahmen von 35 auf 0 und die Projektion von Anweisungstoken von 30 auf 0. Gleichzeitig stieg Clean-Hit@4 von 30/96 auf 96/96.
Das ist noch kein ausgerollter Schutz. Eine Negativkontrolle mit 96 unbeschrifteten Angriffen reproduzierte bei eingeschaltetem Schalter exakt die unsichere Basislinie. Das Audit fand keinen Produktionsindexer, der die erforderlichen Provenienzlabels erzeugt. Außerdem fehlt ein frischer versiegelter Poisoning-Holdout. Der Schalter bleibt deshalb standardmäßig aus. Das Ergebnis belegt nur, dass die Ranking-Kontrolle unter korrekten Labels in diesem synthetischen Fixture funktioniert.
Das Bedrohungsmodell ist von begutachteter Sicherheitsforschung abgeleitet. PoisonedRAG (USENIX Security 2025) beschreibt Wissenskorruption durch eingeschleuste Texte. Liu et al. (USENIX Security 2024) formalisieren die systematische Bewertung von Prompt-Injection-Angriffen und Abwehrmaßnahmen. StruQ (USENIX Security 2025) trennt vertrauenswürdige Anweisungen von unvertrauenswürdigen Daten. Der SupraAgent-Kandidat ist jedoch eine Provenienz- und Ranking-Kontrolle; er implementiert nicht das speziell trainierte Structured-Query-Modell von StruQ.
Leistung: Verteilungen statt einer einzelnen „typischen“ Zeit
Für 256.000 Zeichen berichtet der A/A-Smoke jetzt p50, p95 und p99 nach der Nearest-Rank-Methode, jeweils mit 114 Messungen pro Akteur. Für die Prompt-Phase des Kandidaten lagen die Werte bei 21,655 ms, 49,813 ms und 51,103 ms. Für die Antwortphase lagen sie bei 55,241 ms, 88,084 ms und 94,040 ms.
Die Prozess-RSS-Deltas wurden außerhalb der Zeitmessung erfasst. Bei ebenfalls 114 Stichproben lagen p50/p95/p99 für die Prompt-Phase bei 0/425.984/1.343.488 Bytes und für die Antwortphase bei 65.536/770.048/1.146.880 Bytes. Ein RSS-Delta von 0 bedeutet nicht, dass die Phase keinen Speicher benötigt; es bedeutet nur, dass die zwei Prozess-Snapshots im Median keinen Anstieg zeigten. Kurzzeitige Spitzen, absolute Speicherwerte anderer Prozesse und Produktionscontainer sind damit nicht erfasst.
Parallelität erhöht hier den Durchsatz, aber verschlechtert die Job-Latenz
Ein bewusst kleiner Frischprozess-Smoke schloss sequentiell 2 von 2 Jobs ohne Fehler ab. Die Wall-Time betrug p50 7,713 s und p95 10,884 s. Mit zwei Prozessen wurden ebenfalls 2 von 2 Jobs ohne Fehler abgeschlossen. Der aggregierte Durchsatz stieg von 0,1075 auf 0,1697 Jobs/s, während die mediane Wall-Time pro Job von 7,713 auf 11,778 s zunahm. Die Ergebnis-Digests waren identisch.
Das ist eine Durchsatz–Latenz-Abwägung, kein Latenzgewinn. Mit nur zwei Jobs pro Modus eignet sich der Lauf als Funktions- und Messbarkeitsnachweis, nicht als Kapazitätsplanung oder Produktions-SLO.
Was bewusst nicht übernommen wurde
Ein Kandidat für bessere deutsch-englische Routen über ein Lexikon zeigte Entwicklungsvorteile, bestand aber das Langkontext-Gate L1, die Round-Four-Regression R1 und das p95-Gate M4 nicht. Er wurde verworfen; die Standardeinstellung blieb unverändert.
Auch der bereits geöffnete Poisoning-Datensatz wurde nicht nachträglich als „frischer Holdout“ umetikettiert. Die zugehörige Iteration ist ergebnisoffen, und die Publikationsbereitschaft des Provenienz-Kandidaten bleibt wegen des fehlenden frischen Holdouts und der fehlenden produktiven Labelvergabe auf nicht bereit. Das ist kein administrativer Makel, sondern eine Schutzmaßnahme gegen nachträgliche Erfolgserzählungen.
Wissenschaftliche Grundlage
Die folgenden begutachteten Arbeiten begründen zentrale Teile des Protokolls. Sie sind keine externe Zertifizierung von SupraAgent:
Liu et al., TACL 2024, „Lost in the Middle“: Auswertung nach Position relevanter Information.
Bai et al., ACL 2024, „LongBench“: mehrsprachige, aufgabenbezogene Langkontext-Evaluation.
Zhang et al., Findings of ACL 2025, „LongCite“: getrennte Bewertung langer Antworten und feingranularer Zitate.
Buchmann et al., EMNLP 2024, „Attribute or Abstain“: Attribution und Enthaltung bei langen Dokumenten.
Liang et al., TMLR 2023, „HELM“: transparente, mehrdimensionale Evaluation statt eines undurchsichtigen Gesamtscores.
Smucker, Allan und Carterette, CIKM 2007: gepaarte Vergleiche in der Information-Retrieval-Evaluation.
Zou et al., USENIX Security 2025, „PoisonedRAG“, Liu et al., USENIX Security 2024 und Chen et al., USENIX Security 2025, „StruQ“: Korpusvergiftung, Prompt Injection und die Trennung von Anweisungen und Daten.
Was die 30 Iterationen verbessern – und was offen bleibt
Der Benchmark ist nach diesem Zyklus aussagekräftiger, weil er keine einzelne gute Zahl in den Vordergrund stellt. Er zeigt Positionseffekte, vollständige Nenner, falsche Enthaltungen, den Retrieval–Zitat–Lead-Trichter, Teillesung, Scan-Wiederverwendung, Quantile mit Stichprobengröße, Prozess-RSS-Deltas und die gegensätzliche Entwicklung von Durchsatz und Einzellatenz. Er bewahrt zugleich verworfene und ergebnisoffene Iterationen.
Offen bleiben vier Voraussetzungen für stärkere Produktbehauptungen:
ein frischer, vor der Auswertung versiegelter Poisoning-Holdout;
verlässliche Provenienzlabels aus dem Produktionsindex;
unabhängige semantische und UX-Bewertungen mit repräsentativen Nutzerfragen;
Lasttests in einer produktionsnahen Umgebung mit ausreichend Wiederholungen.
Die öffentliche Veröffentlichung des 30-Iterationen-Updates wurde am 17. November 2026 für beide Sprachfassungen verifiziert. Für die deutsche Fassung wurden ein neueres dateModified als vor dem Zyklus und der Marker „30 Benchmark-Iterationen“ auf der anonym erreichbaren Seite bestätigt.
Fazit: Der belastbare Fortschritt dieses Zyklus liegt vor allem in der Messqualität. Wir wissen genauer, wo Retrieval verliert, wann Teillesung stattfindet, wie stark Positionseffekte ausfallen können und welche Voraussetzung der Provenienzschutz noch nicht erfüllt. Das ist weniger spektakulär als ein „weltbester“ Score, aber für ein verlässliches Produkt wesentlich nützlicher.